job match(career.enludus.com)は、公開されている求人ページと、自分が仕事に求めていることを並べて、近い点・違う点・まだ分からない点 に分けて見せる Web ツールです。採否や能力を判定するものではありません。応募するかどうかを考えるときの材料を、整理して手元に置くためのものです。
この記事では、何を作ったのか、どう使うのか、作りながら何に悩んだのかを書きます。
なぜ作ったか
求人の条件は、会社ごとに書き方がばらばらで、自分に合うかどうかを比べにくいと感じていました。
年収を表の中に書く会社もあれば、本文の途中に書く会社もあります。「リモート可」も、週に何日出社するのか、会社全体の制度の話なのか、その求人の話なのかで意味が変わります。何件か見比べているうちに、自分が何を基準に比べていたのかが分からなくなってきます。
そこで、先に自分の基準を決めておき、どの求人もその同じ基準で読む、という道具を作ることにしました。
使い方
1. 自分の軸を入力する
最初に 3 つのことを聞きます。3 分ほどで終わります。
- 見ている職種
- 8 つの軸:働く場所、裁量、協働、成長の方向、仕事の変化、勤務時間の柔軟性、役割の幅、顧客との接点。それぞれ 0〜100 のスライダーで希望を入れ、別に「どれくらい重視するか」を選びます。「比較しない」を選んだ軸は、比較から外れます。
- 譲れない条件:最低年収(額面)、勤務地(都道府県)、フルリモート必須。
希望と重視度を分けているのは、「在宅が多い方がいいけれど、そこまでこだわらない」と「フルリモートでなければ困る」を区別したいからです。後者は軸の一つとしてではなく、譲れない条件として別に確かめます。軸が近くても、譲れない条件を満たさなければ「満たさない」と表示します。
2. 求人を選ぶ
企業名を入れると、その会社の公開求人を探します。職種も入れると、候補を絞り込めます。求人の URL を知っていれば、直接貼ることもできます。
初めて見る求人は、裏で取得と解析をするので少し待ちます。一度解析した求人は、ほかの人が同じ求人を見るときにも使い回します。
3. 結果を読む
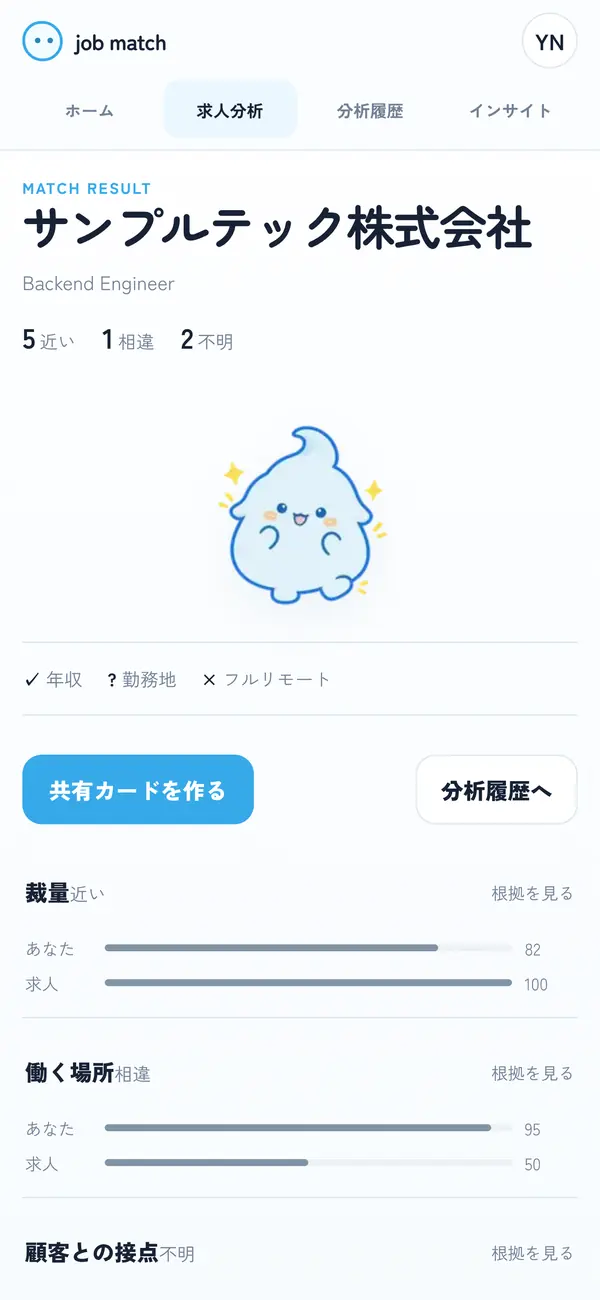
結果画面は、前半と後半に分けています。
- 前半は 「求人に書いてあること」。給与・勤務地・出社条件などの概要と、仕事内容・働き方・求める人物を、ページの原文のまま引用します。要約はしません。
- 後半は 「あなたとの比較」。譲れない条件を満たすかどうかと、8 つの軸が近いか違うか。どの判定にも、ページ上の根拠を付けます。
軸の判定は「近い」「相違」「一部近い」「不明」といった言葉だけで示します。総合点や「適合率 ◯%」は出しません。会社全体の情報も見られますが、「この求人に当てはまるとは限らない参考」として、求人の結果とは分けて表示します。
4. あとから見比べる
比べた求人は「分析履歴」に残ります。希望職種で絞り込んだり、「相違あり」「不明あり」の求人だけを出したり、「近いが多い順」「不明が少ない順」に並べたりできます。ここでも並べ替えに使うのは軸の数え方だけで、求人に点数を付けることはしていません。
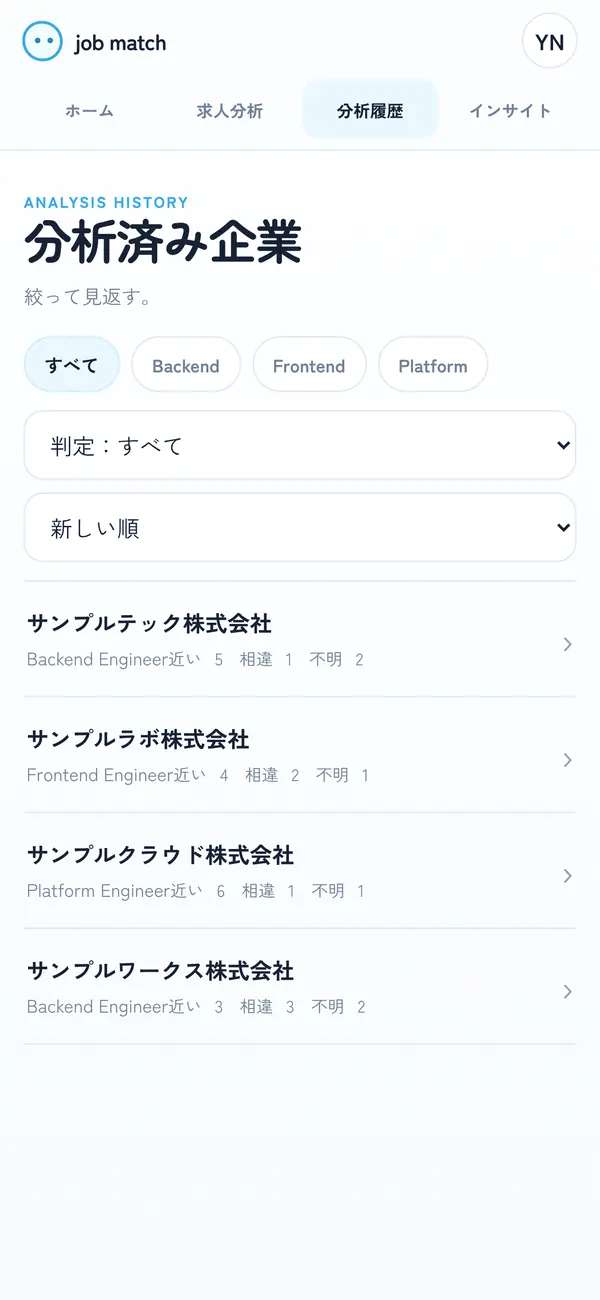
希望条件はいつでも見直せます。見直すと新しい版として保存され、過去の比較は、当時の希望で比べた結果のまま残り、新しい希望で上書きされることはありません。
AI は整理するだけ、決めるのは本人
このツールで一番大事にしているのはここです。
求人ページを読む部分では AI を使っています(TypeSafe の Jev という、判定のためのモデルです)。ただし、AI に文章を書かせたり、数値を作らせたりはしていません。AI に尋ねるのは、たとえば次のような 決まった選択肢から選ぶ質問 だけです。
- この求人の「働く場所」は、0(出社前提)・50(出社と在宅の併用)・100(フルリモート可)・記述が矛盾・判断材料なし、のどれか
- その判断を支えているのは、ページのどの断片か
選択肢にないものは、仕組みの上で返せません。存在しない引用や、ページにない URL が結果に混ざることはありません。さらに、自信が足りない判定や、根拠の場所を指せない判定は、すべて「不明」にします。
給与や「週 2 日出社」のように書き方が決まっているものは、AI に聞く前にプログラムで読み取ります。AI に頼るのは、言い回しの幅が大きく、プログラムでは読み切れない部分だけです。
もう一つの約束は、「不明」を 0 点として扱わない ことです。書いていないことを、低い評価にすり替えない。会社全体の制度を、その求人にも当てはまると推測しない。この約束は画面の文言だけでなく、プログラムの型やデータベースの制約にまで入れてあります。
総合点を出さないのも、同じ考えからです。どの違いが決定的で、どの違いは気にならないかは、人によって違います。点数にまとめてしまうと、その判断をツールが勝手にしてしまう。だから、並べて見せるところまでにとどめています。画面にも「採否・能力・人柄を判定するものではありません」と書いています。
難しかったこと
「不明」だらけになった
最初の版で実際の求人を解析すると、8 軸のうち 6 軸が「不明」になる結果が続きました。ところが本文を見ると、判断材料はちゃんと書いてあります。原因を追うと、いくつかが重なっていました。
- 求人ページが給与欄を描くのに使う 2MB ほどのプログラムを、安全のための容量制限で読み込まずにいた。そのため、給与の欄が空のまま読んでいた。
- 表の「年収」というラベルと「600万円〜1600万円」という値を、別々の断片として扱っていた。
- 長い文を機械的に 200 文字で切っていて、条件の途中で文が切れていた。
- 判定の基準が、利用者に聞いている質問の意味より厳しすぎた。
どれも、AI の自信の基準を下げて「不明」を減らす方向では直していません。それは推測を増やすだけだからです。ページに書いてあることを、落とさずに読む 方を直しました。
「書いていない」と「幅がある」
直したあとに残った「不明」を調べると、多くは「根拠ははっきりあるのに、50 と 100 のどちらとも言い切れない」状態でした。同じページで何度聞いても、確率がほぼ半々に割れます。
これを「不明」と表示すると、「何も書いていない」と区別がつきません。かといって、少しでも高い方を採るのはコイン投げと同じです。
そこで、隣り合う 2 つの点のあいだと読めるときは「50〜100」という 範囲 として記録し、両端で希望と比べることにしました。両端とも近ければ「近い」、両端とも遠ければ「相違」、片方だけ近ければ「一部近い」です。あいだのどこかを推定することはしません。実際の求人 5 件で試すと、「不明」が 19 件から 9 件に減りました。残った 9 件のうち 7 件は、配属先で仕事が変わるオープンポジションで、書いていないこと自体が正しい結果でした。
企業名から求人を探す
URL を知らなくても、企業名から求人にたどり着けるようにしたいと考えました。最初は検索エンジンの結果を手がかりにしていましたが、何度か検索するとボットと判定され、ほとんど結果が返らなくなりました。有料の検索 API は使わずに進めたかった。
そこで、企業名から Wikipedia と Wikidata をたどって公式サイトを特定し、公式サイト自身が公開している採用ページやサイトマップから求人を集める方法に変えました。検索エンジンは、それで見つからないときの予備です。どの経路で見つけた候補も、ページを実際に取得して、求人であること、会社名が一致すること、募集が終わっていないことを確かめてから保存します。
よそのサイトを読むということ
他社のサイトを読みに行く道具なので、取得の仕方には気を使っています。robots.txt で禁止されているページは読みません。ログインが必要なページも読みません。読む大きさ・時間・リダイレクトの回数には上限を設け、社内ネットワークのような公開されていない宛先には接続しません。取得した本文は 30 日で消します。
個人の情報について
- ログインは Google アカウントで行います。
- 求人の解析結果は、利用者全員で共有します。そこに個人の希望は混ぜません。比較は、共有の解析結果と本人の希望を、本人に対してだけ行います。
- 結果を人に見せるリンクも作れますが、見えるのは企業名・職種・軸ごとの判定だけです。希望の値や年収、勤務地は含みません。リンクはいつでも止められます。
- 退会すると、個人のデータはまとめて削除されます。
これから
課題はまだあります。
- 求人の一覧を JavaScript でしか描かず、サイトマップもない採用サイトは、企業名からは見つけられません。
- Wikipedia に記事のない企業は、公式サイトを特定できず、検索エンジンの予備に頼ることになります。
- 給与が月給や時給で書かれた求人は、年収の条件とは比べず「判定できず」と表示します。勝手に年収へ換算しないためです。
- 入力した希望職種と、求人の職種を自動で突き合わせる仕組みはまだありません。
どれも「推測で埋めない」を守ったまま、読める範囲を少しずつ広げていくつもりです。使ってみて気になったことがあれば、ぜひ教えてください。
公式サイトの探索、安全な取得の境界、AI への質問の組み立て方、「不明」の型とデータベースの制約、範囲の比較、キャッシュと費用の抑え方まで、コードを引用して追った技術編は「job match の求人照合を全部書く」に書きました。