これは技術編です。何をつくって、実験がどうだったかを読みやすくまとめた読みもの版は「ファイルを音で送ったら、秒速 1.2 ビットだった」にあります。
Logiscore は、テキストやソースコード、フォルダごとを 音 にして、スピーカーで鳴らし、別の端末で録音した音声から 元のバイト列を完全に 戻すブラウザアプリです。符号化・誤り訂正・暗号・復号はすべて Rust で書き、wasm-pack で WebAssembly にしてブラウザ内で動かしています。サーバーにファイルは送りません。
この記事では、空気を通す「Reliable WAV」経路を、送信側から順に全部書きます。数字はリポジトリの ADR・実験報告・ソースの値です。
全体のパイプライン
payload (Text / Source File / Project)
  → zlib (level 6)
  → v2 packet (Binary Header + body)
  → FEC profile 1: CRC-32 → Hamming SECDED(13,8) → 8 符号語インターリーブ → ×3
  → [Secure のときは先に AEAD envelope]
  → PCM 8 kHz mono(16 音 FSK + 同期 + 長さヘッダ)
  → WAV / スピーカー
       ↓ 空気 1 m
  → iPhone ボイスメモ(AAC / M4A)
  → Web Audio で PCM に → Rust で 8 kHz にリサンプル
  → 同期検出 → Goertzel で nibble 判定
  → 多数決 → デインターリーブ → SECDED → CRC-32 → inflate
  → 元のバイト列
MIDI を出力するモード(Auto / Fast / Music)もありますが、これは「1 音 = 1 バイト」を音楽として聴かせる別系統です。上位 4 ビットを 16 音の音階上の高さ(-8〜+7)、下位 4 ビットを velocity(idx*8+7)にし、16 チャンネル × 3 音 = 48 バイト/tick で詰めます。ヘッダは MIDI のテキストメタイベント(LOGISCORE:v1、SCALE、ROOT、LEN)に入れています。MIDI はバイナリとしては正確ですが、DAW を一度通すと壊れることがあるので、空気を通すのは次の PCM 経路です。
1. 変調:16 音の FSK を 8 kHz で
物理伝送のいちばん保守的なプロファイル(FixedFallback)は、1 シンボル = 1 nibble = 1 音 です。
// packages/harmonic-core/src/audio/fixed.rs
const SYMBOL_TONE_MS: u32 = 80;
const SYMBOL_REST_MS: u32 = 40;
const FIRST_SYMBOL_NOTE: u8 = 60; // MIDI 60 = C4

for nibble in packet.iter().flat_map(|byte| [byte >> 4, byte & 0x0f]) {
    append_tones(&mut samples, &[FIRST_SYMBOL_NOTE + nibble], tone_samples, sample_rate, 0.6);
    append_silence(&mut samples, rest_samples);
}
nibble 0〜15 を MIDI ノート 60〜75(約 261.6Hz〜622.3Hz)の正弦波にし、1 音 80ms、休符 40ms。1 バイトは 2 シンボルなので 240ms/バイト、生の速度は 4 bit ÷ 0.12 s ≈ 33.3 bps です。
8 kHz にしているのは、使う周波数が最高でも約 2.1kHz(同期音の MIDI 96 ≈ 2093Hz)で、ナイキスト周波数 4kHz に収まるからです。サンプル数が少ないほど、WASM での処理も軽くなります。
フレーミング
データの前に、同期と長さを置きます。
| 区間 | 内容 | 長さ |
|---|---|---|
| 先頭の無音 | 80ms | |
| 同期(高) | MIDI 96 | 160ms |
| すき間 | 40ms | |
| 同期(低) | MIDI 84 | 160ms |
| 無音 | 80ms | |
| 長さヘッダ | 32 bit、MSB first。0 = MIDI 88、1 = MIDI 92 | 40ms × 32 |
| 無音 | 80ms | |
| データ | 16 音 FSK | 120ms × 2 × バイト数 |
フレーミングだけで 1,880ms。パケット長の上限は 4 KiB、PCM 入力の上限は 16,000,000 サンプル(8kHz で約 33 分)に制限しています。
2. 検出:FFT ではなく Goertzel
受信側が知りたいのは「16 個の候補周波数のうち、どれがいちばん強いか」だけです。全スペクトルを出す FFT は要らないので、候補周波数ごとに Goertzel アルゴリズム を回しています。依存ライブラリも増えません。
// packages/harmonic-core/src/audio/decode.rs
pub(super) fn goertzel(samples: &[f32], frequency: f32, sample_rate: u32) -> f32 {
    let coefficient = 2.0 * (std::f32::consts::TAU * frequency / sample_rate as f32).cos();
    let mut previous = 0.0;
    let mut before_previous = 0.0;
    for &sample in samples {
        let current = sample + coefficient * previous - before_previous;
        before_previous = previous;
        previous = current;
    }
    let power = previous * previous + before_previous * before_previous
        - coefficient * previous * before_previous;
    power / (samples.len().max(1) as f32).powi(2)
}
式にすると、係数 c = 2cos(2πf/fs) で s[n] = x[n] + c·s[n−1] − s[n−2] を回し、最後に s₁² + s₂² − c·s₁·s₂ を N² で正規化したものがその周波数のパワーです。1 周波数あたり O(N) なので、16 候補でも 640 サンプル(80ms)× 16 回の掛け算で済みます。
ここで効いてくるのが 周波数分解能 です。窓が 80ms(N = 640)だと分解能は fs/N = 12.5Hz。一方、いちばん低い候補 MIDI 60 と 61 の差は 261.6Hz → 277.2Hz で 約 15.6Hz しかありません。分解能に対して余裕は 1.25 倍ほどで、シンボル長を短くするとすぐ隣の音と区別がつかなくなります。80ms という長さは、この制約から来ています。
判定は単純で、16 候補のエネルギーの最大を取ります。
fn decode_nibble(self, samples: &[f32]) -> Result<u8, LogiscoreError> {
    (0..16u8)
        .map(|nibble| (goertzel(samples, midi_frequency(FIRST_SYMBOL_NOTE + nibble), sr), nibble))
        .max_by(|l, r| l.0.total_cmp(&r.0))
        .filter(|(energy, _)| *energy > MIN_SYMBOL_TONE_ENERGY) // 1e-8
        .map(|(_, nibble)| nibble)
        .ok_or_else(|| invalid_audio("fixed symbol was not detected"))
}同期音は、絶対的な下限(1e-4)に加えて「期待する音のエネルギーが、もう一方の 2 倍以上」という 相対 判定もしています(expected < alternate * 2.0 なら拒否)。後で書く実録音のバグは、ここの考え方の違いに関係します。
3. 誤り訂正:FEC profile 1
空気を通すと、単発のビット化けと、雑音でまとめて壊れるバースト誤りの両方が起きます。Reed–Solomon の crate を入れる案もありましたが、WASM のサイズ、依存の監査、長期の保守 を考えて、小さく自分で読める部品を重ねる方を選びました。
compressed payload
  → CRC-32 を付ける
  → Hamming SECDED (13,8)
  → 8 符号語ビットインターリーブ
  → 保護済みストリーム × 3
Hamming SECDED (13,8)
8 ビットのデータを 12 ビットの Hamming 符号にし、全体パリティを 1 ビット足して 13 ビットにします。
// packages/harmonic-core/src/error_correction/hamming.rs
const CODEWORD_BITS: usize = 13;
const DATA_POSITIONS: [usize; 8] = [3, 5, 6, 7, 9, 10, 11, 12];
const PARITY_POSITIONS: [usize; 4] = [1, 2, 4, 8];
位置 1・2・4・8 がパリティ、残りがデータ、13 ビット目が全体パリティ。復号ではシンドローム(4 つのパリティの不一致を位置番号として読んだ値)と全体パリティの組み合わせで分岐します。
| シンドローム | 全体パリティ | 意味 | 処理 |
|---|---|---|---|
| 0 | 一致 | 誤りなし | そのまま |
| 0 | 不一致 | 全体パリティのビットだけ化けた | 訂正済みとして数える |
| 1〜12 | 不一致 | 1 ビット誤り | その位置を反転 |
| それ以外 | — | 2 ビット以上の誤り | 拒否 |
1 ビットは直し、2 ビットは「直せない」と確実に気づける。これが SECDED(Single Error Correction, Double Error Detection)です。
インターリーブ:バーストを散らす
SECDED は 1 符号語に 1 ビットまでしか直せません。そこで 8 符号語を 1 ブロックにして、ビットの順番を 転置 します。
// packages/harmonic-core/src/error_correction/interleave.rs
for block_start in (0..codeword_count).step_by(depth) {
    let block_size = depth.min(codeword_count - block_start);
    for bit_index in 0..codeword_bits {          // 13
        for codeword_offset in 0..block_size {   // 8
            output.push(bits[(block_start + codeword_offset) * codeword_bits + bit_index]);
        }
    }
}
送信時は「符号語 0 の bit0、符号語 1 の bit0、…、符号語 7 の bit0、符号語 0 の bit1、…」の順に並びます。すると、連続 8 ビットまでのバーストは 8 つの別々の符号語に 1 ビットずつ 散らばり、全部 SECDED で直せます。
3 重の多数決
保護済みストリームを丸ごと 3 回送り、受信側でビットごとに多数決をとります。
// packages/harmonic-core/src/error_correction/repetition.rs
let votes = (0..repetitions)
    .filter(|copy| data[copy * copy_length + byte_index] & mask != 0)
    .count();
if votes > repetitions / 2 { byte |= mask; }
1 つのコピーの中でまとまって壊れても、残り 2 つが正しければ戻ります。コピー数は奇数・3 以上に限定し、偶数は拒否しています。
最後に CRC-32
ここまで通っても、SECDED が見逃す 3 ビット以上の誤りはありえます。復号の最後に IEEE CRC-32 を照合し、合わなければ捨てます。「間違ったデータを正しいと言わない」 ことを最終条件にしています(なお CRC は偶発誤りの検出用で、改ざん対策は後述の AEAD の役目です)。
コスト
容量は 13/8 × 3 = 4.875 倍 になります。生の 33.3 bps に対して、誤り訂正込みの上限は約 6.8 bps。Reed–Solomon より効率は悪いですが、この段階では「確実に戻ること」と「中身を説明できること」を優先しました。
環境ごとの強さは、プロファイル表で切り替えます(Quiet / Balanced / Conversation / Noisy / Online / LongDistance / FixedFallback)。Conversation はインターリーブ深さ 16・3 重、Noisy・Online・LongDistance は深さ 16・5 重。自動選択は、キャリブレーションで測ったノイズフロア・SNR・クリッピング率・残響から 決定的なしきい値表 で選びます。機械学習にしなかったのは、送信側と受信側、ネイティブと WASM で 同じ入力から必ず同じ結果 が出ることを優先したからです。
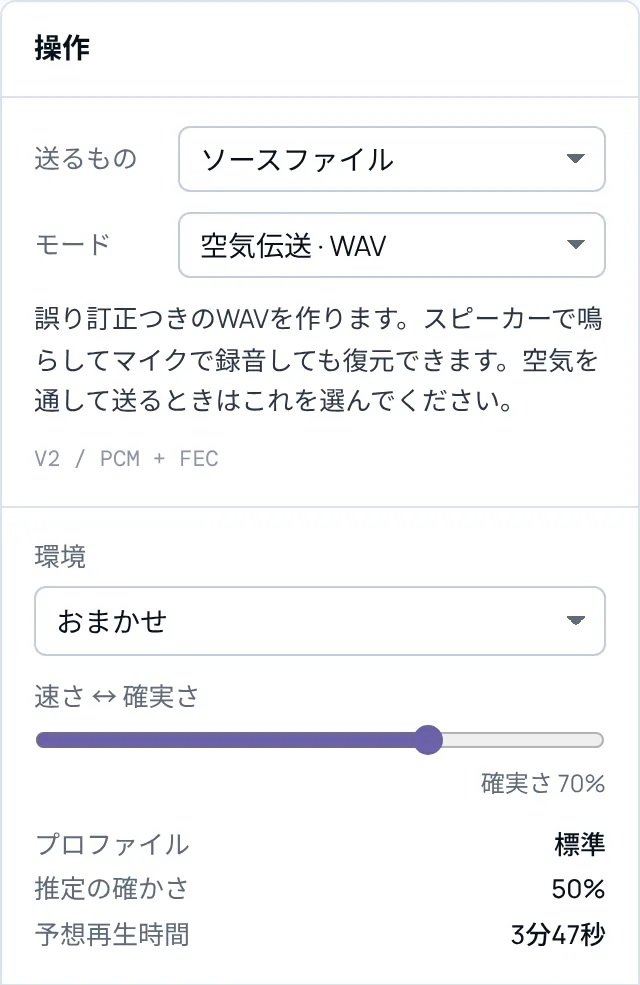
4. 実験:MacBook → 空気 1m → iPhone
ここからが本番です。
- 送信:MacBook のスピーカーで WAV を再生
- 経路:空気 1m
- 受信:iPhone のボイスメモで録音(AAC の M4A)
- 復号:ブラウザの Web Audio で PCM に戻し、Rust で 8kHz に線形リサンプル
録音の原本は SHA-256 付きでテスト用コーパスに入れ、Playwright で毎回「完全一致」を確かめるようにしています。
3 ビットしか間違っていないのに、全部捨てていた
最初、この録音は戻りませんでした。調べると、届いたパケットの誤りはたった 3 ビット。インターリーブと SECDED と多数決なら余裕で直せる量です。
原因は、誤り訂正より 手前 にありました。シンボル判定に「エネルギーの絶対値がこの値より小さければ検出失敗」という床(absolute energy floor)があり、1 つだけ弱く録れたシンボルがそこで落ちて、パケット全体が FEC に届く前にエラーになっていた のです。
直し方は、「同期の相対判定は残し、データシンボルの絶対的な足切りを、FEC に渡せるところまで下げる」。現在の値は MIN_SYMBOL_TONE_ENERGY = 1e-8 です。誤っているかもしれないシンボルも、とりあえず最大エネルギーの候補として後段に渡し、正しいかどうかは誤り訂正と CRC に判断させる。判定を早い段階でしすぎない というのが、この件のいちばんの学びでした。
ほかに、AAC エンコードの priming による 2 サンプルの時間ずれ も許容するようにしています(再生時間の比較で 1ms 未満だけ許す。復元の正しさは厳密一致のまま)。
結果と、正直な数字
修正後、録音から元のテキストが 完全一致 で戻りました。品質ゲートは Rust のテスト 180 件、Playwright 25 件、cargo audit で既知の脆弱性なし。
そして速度です。
| 時間 | 実効速度 | |
|---|---|---|
| FixedFallback(生成した音声) | 約 136.72 秒 | — |
| 実録音 | 約 139.71 秒 | 約 1.20 bps |
計算上の上限 6.8 bps と実測 1.20 bps の差には、フレーミング(固定 1.88 秒)、v2 ヘッダ、CRC、zlib のヘッダなど固定分のオーバーヘッドが含まれます。内訳はまだきちんと分解していません。それから、単音が淡々と並ぶので、音は正直 シンセっぽくて少し不気味 です。音楽として聴ける音色にすることは、通信が成立することとは分けて、別の課題として扱っています。
5. Secure モード:パスワードで暗号化してから音にする
magic(4) | version(1) | kdf_id(1) | aead_id(1) | salt(16) | nonce(12) | ciphertext + tag(16)- KDF:Argon2id v19、メモリ 64 MiB、3 回、1 レーン、32 バイト鍵(RustCrypto
argon2 0.6) - AEAD:ChaCha20-Poly1305(RFC 8439、
chacha20poly1305 0.11) - 乱数:salt 16 バイトと nonce 12 バイトを OS の CSPRNG から(WASM では Web Crypto 経由、
getrandom 0.4) - 先頭 35 バイトのヘッダ全体を AAD にして、ヘッダの改ざんも検出する
- 導出した鍵は
zeroizeで drop 時に消す - 復号側はヘッダの KDF パラメータを 信用しない。version・KDF・AEAD は固定値と照合し、音声に書かれた任意のコストで KDF を回すことはしない
- 認証失敗は理由を区別せず、1 種類の安全なエラーにまとめる
PBKDF2 を選ばなかったのは、メモリハードではなく総当たりに弱いから。AES-GCM も有力でしたが、ハードウェア AES に頼らない純 Rust / WASM では ChaCha20 の方が安定して速い。暗号を UI 側の Web Crypto に置かず Rust に集約したのは、ネイティブとブラウザで同じテストベクタ・同じ失敗の扱い にしたかったからです。
代わりに、64 MiB を確保できない端末では Secure モードが動かない可能性があります。
6. 途中から録音しても戻したい:チェックポイントと soft combine
ここまでの方式は、録音が 先頭の同期音から 始まっている必要があります。ループ再生のどこから録り始めても戻せるように、完成した v2 パケットの外側を分割する層を足しました。
Magic 4 | Version 1 | Transfer ID 4(全パケットの CRC-32)
| Chunk Index 2 | Chunk Count 2 | Total Packet Length 4 | Chunk Length 2
| Chunk Payload 0..768(既定 512) | Chunk CRC-32 4
固定 23 バイトのオーバーヘッドで、
- チャンクはどの順番で届いてもよい。全 index がそろった時点で組み立てる
- 同じ index を複数回受け取ったら完全一致の多数決。同数なら曖昧として拒否
- 組み立てたあと、全体の CRC を Transfer ID と照合する
チェックポイントごとの同期は、従来の約 3.6 秒のフル同期の代わりに、60ms の高低 2 音と 10 ビットの長さ(最大 1023 バイト)だけの Mini Sync にしました。空フレームで旧方式の 1/4 未満です。
3 周とも壊れていても戻す
各 nibble を判定するとき、最大エネルギーと次点の差を 0〜1 の 確からしさ(confidence) として残しておきます。ループを 3 周録って、
- 1 周目は nibble A が化けて CRC 不合格
- 2 周目は nibble B が化けて CRC 不合格
- 3 周目は nibble C が化けて CRC 不合格
という状況でも、同じ Transfer ID・同じ chunk の観測を confidence で重み付けして nibble ごとに投票 すれば、正しいバイト列が組み上がります。もちろん、統合したあとにチャンクの CRC と全体の CRC を必ず通します。CRC を迂回する近道は作っていません。メタデータ自体が壊れた観測は、安全にまとめられないので捨てます。
この部分は Rust のテスト 197 件、Playwright 28 件(3 周すべてを別々の場所で壊した PCM からの復元を含む)で確かめています。まだ本番の画面にはつないでおらず、iPhone での実録音もこれからです。
まだやっていないこと
- 3m・5m の距離、ほかの端末での実録音
- Source File・Project の実録音
- 音楽として聴ける音色のプロファイル(同じ 6 指標で、通信の成立と比べて採用する)
- 実効 1.2 bps の内訳の分解と、そこからの高速化
速くはありません。でも、ネットワークもサーバーも使わずに、空気の振動だけでファイルが 1 バイトも違わずに届く。その確かさを、ひとつずつ数字で積み上げていくのが楽しいところです。